

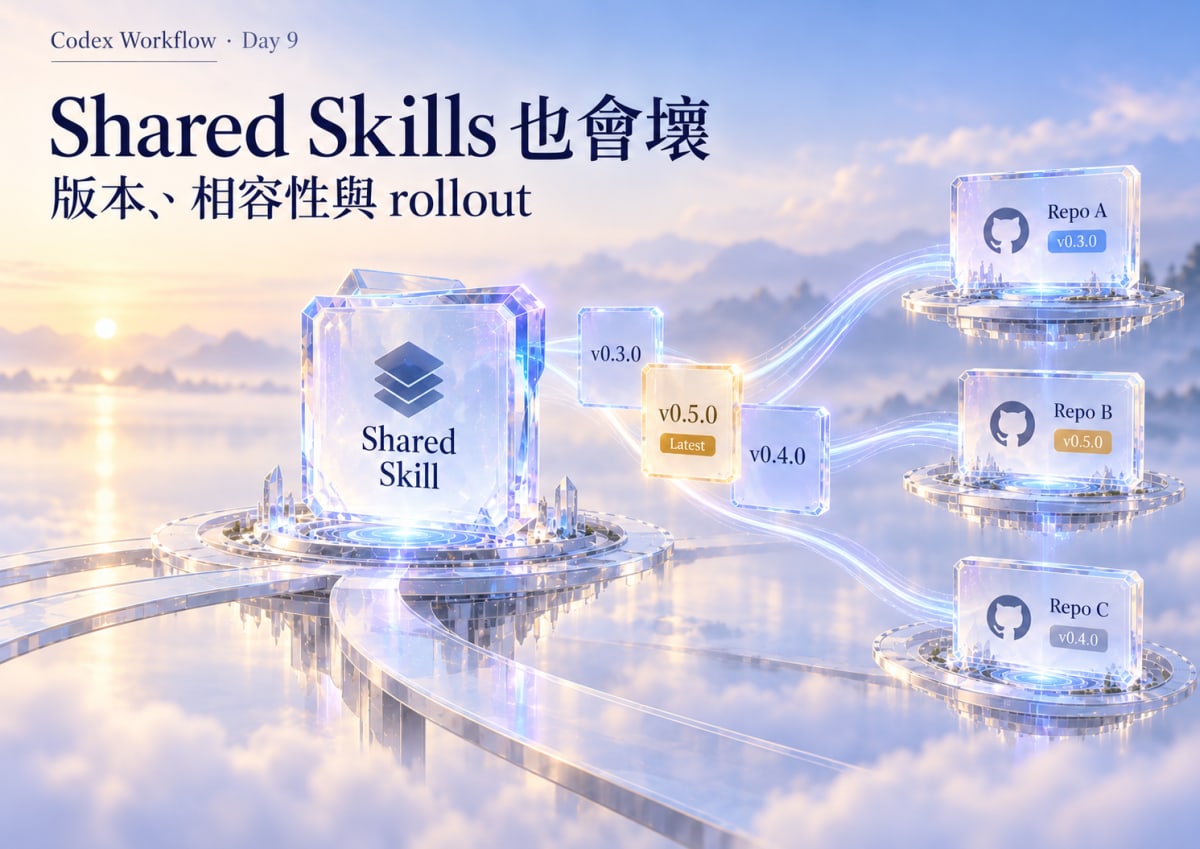
Day 8 把一部分重複 Prompt 抽成 Skill 之後,問題沒有結束。
反而多了一個以前不存在的狀態:
同一個 Skill
中央版本已更新

Repo A 還在用舊版
Repo B 剛同步新版
Repo C 手上的內容被局部修改過
只要 Shared Skill 開始被多個 Repository 使用,「共用」就不再只是少複製幾份文字。
它開始像一個被其他專案依賴的元件。
而且這個元件有點特殊。
一般 Library 壞掉,常見結果是 compile error、test failure 或 runtime exception。
Agent 規則漂移時,系統甚至可能還能正常執行,只是不同 Repository 裡的 Agent 已經在遵守不同版本的工作契約。
這比單純的「檔案不同步」更麻煩。
因為你很難回答:
現在這個 Agent,到底是在依哪一套規則工作?
這就是我的 Shared Skills 後來開始需要版本、release boundary 與 rollout 的原因。
最直覺的做法很簡單。
假設有兩個跨 Repository 都會用到的能力:
ap-safe-preflight
ap-verification-core
中央 Repository 保存 canonical copy。
其他專案需要時再載入。
概念上像這樣:
agent-platform
├─ ap-safe-preflight
└─ ap-verification-core
       ↓
       ↓
Repo A
Repo B
Repo C
只看「不要重複維護」這個需求,這已經足夠。
但專案真的開始各自演進後,很快出現幾個問題:
最後一題尤其危險。
因為「最新」看起來很方便,卻把 consumer 的行為綁在一個會移動的目標上。
今天重新跑同一個 Repository,載入到的規則可能已經和昨天不同。
程式碼沒有改。
Prompt 沒有改。
但 Agent 的行為契約改了。
目前的 consumer contract 會把 Shared Skill 直接宣告在 manifest 裡。
簡化後大致像這樣:
shared_source:
  ref: "v0.8.0"

shared_skills:
  - id: ap-safe-preflight
    version: "0.3.0"
    path: ".agents/skills/ap-safe-preflight"

  - id: ap-verification-core
    version: "0.5.0"
    path: ".agents/skills/ap-verification-core"
這裡有兩層 identity。
第一層是:
shared_source.ref
它回答:
這批 Shared Skills 是從哪一個正式 release 來的?
第二層是每一個 Skill 自己的:
metadata.version
它回答:
這個 Skill 宣告自己是哪一版?
consumer 啟動 mutation 前,兩邊必須對得起來。
例如 manifest 寫:
ap-verification-core = 0.5.0
但實際 snapshot 裡的 SKILL.md 是:
metadata.version = 0.4.0
這不是「之後有空再整理」的文件問題。
在目前的 contract 裡,它直接視為失敗,只允許 read-only diagnosis,不繼續 mutation。
因為這時已經無法確定:
Agent 接下來遵守的,到底是 manifest 宣告的規則,還是磁碟上那份規則?
做一般應用時,版本號常被理解成:
v1.2.3
→ 這次加了哪些功能?
Shared Skill 的版本還多一個用途:
建立行為規則的 identity。
例如 ap-safe-preflight 後來加入新的 Product Intent / Complexity Tripwire;ap-verification-core 也逐步增加 scope-drift classification 與不同 verification evidence。
如果 consumer 沒有版本邊界,只看到:
ap-safe-preflight
這個名字提供的資訊還不夠。
同一個名字,在不同時間可能代表不同 contract。
我會把四個東西一起看:
Skill name
+
Skill version
+
Release ref
+
Committed snapshot
這樣事後回頭看一次 Agent 修改時,才有機會重建它當時依的是哪一套治理規則。
因為中央最新版有兩個語義混在一起。
一個是:
目前正在編輯的內容
另一個是:
已正式交付、可以被 consumer 信任的內容
這兩者不能自動畫等號。
在目前的 Shared Skill lifecycle 裡,consumer 不直接依賴 canonical working tree,也不追 branch HEAD。
它依賴 immutable release ref。
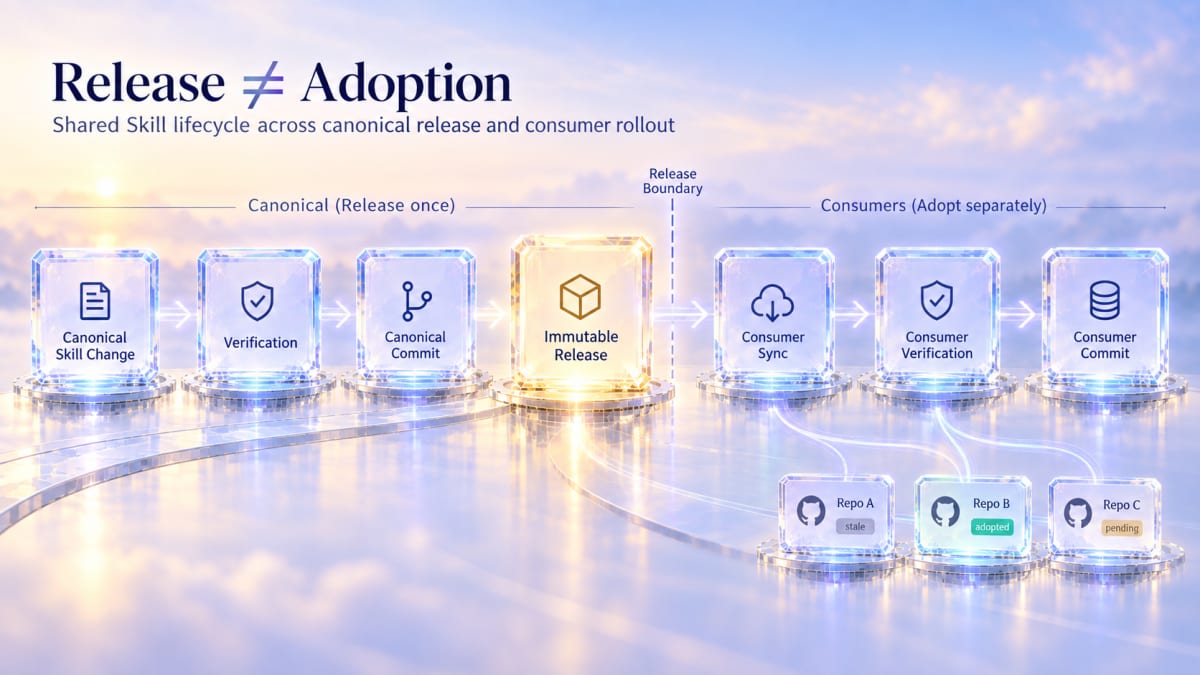
流程被刻意拆開:
canonical Skill change
        ↓
verification
        ↓
canonical commit
        ↓
immutable release tag
        ↓
consumer sync
        ↓
consumer verification
        ↓
consumer commit
這樣做比較慢。
但慢的地方有意義。
因為每一道邊界都在回答不同問題:
| 階段 | 要回答的問題 |
|---|---|
| canonical verification | 新規則本身有沒有明顯問題? |
| release tag | 哪一個 commit 是正式交付邊界? |
| consumer sync | consumer 這次到底拿了什麼? |
| consumer verification | 同步後 manifest、snapshot、版本是否一致? |
| consumer commit | 這個 Repository 從哪一刻開始採用新版? |
如果把它壓成:
永遠拿 latest
前面這些問題全部會被藏起來。
做到這裡,很容易產生下一個衝動:
既然版本都定義好了,那就讓所有 consumer 自動升到最新版。
我反而不這樣做。
原因很簡單。
Shared Skill 不是純資料檔。
它會改變 Agent:
升級 Skill 有可能直接改變工程流程。
Rollout 至少要拆成兩件事:
Release
≠
Adoption
中央可以先發布新版本。
consumer 要不要升級,仍然是一個獨立決策。
這讓不同 Repository 可以有自己的節奏,也保留 rollback 與相容性檢查的空間。
另一個後來被補上的規則,是:
consumer snapshot 和 canonical 不同,不代表 consumer 一定錯。
差異可能有很多來源:
MATCH
STALE_CONSUMER
CONSUMER_ONLY_ENHANCEMENT
CANONICAL_REGRESSION
LOCAL_DRIFT
UNRESOLVED
例如某個 consumer 補了一段 Windows / Android 的環境處理。
第一眼看起來,它只是「偏離中央版本」。
但下一步不應該直接 copy canonical 覆蓋掉。
應該先問:
這也是為什麼把「upstream」和「sync」拆成兩種工作。
consumer enhancement
        ↓
inspect / classify
        ↓
canonicalize reusable intent
        ↓
canonical review
        ↓
new release
        ↓
downstream sync
同步是 deterministic file operation。
判斷一段 consumer 規則值不值得回到 canonical,則是 semantic decision。
兩件事混在一起,很容易讓「更新版本」順便變成「自動批准規則」。
它還不是完整的 package ecosystem,也沒有 registry、dependency solver 或自動更新服務;甚至刻意避免把它做那麼重。
但只要同時出現 canonical source、consumer、version、release、sync 與 compatibility,最低限度就要能回答:
SOURCE      規則從哪裡來?
IDENTITY    是哪個 release / Skill version?
INTEGRITY   consumer snapshot 是否等於該 release?
ADOPTION    哪些 consumer 已採用?
DIVERGENCE  差異是 stale、local,還是值得 upstream?
ROLLBACK    能不能回到明確的舊 release?
否則很容易變成:
大家都說自己在用同一套規則
但每個 Repo 的規則已經不一樣
Shared Skill 的 breaking change,有時不會讓 parser 爆掉。
例如某一版開始新增:
缺少 manifest version
→ read-only only
另一版又增加:
version mismatch
→ contract failure
對 YAML 或 Markdown 而言,檔案都還是合法的。
但對 Agent Workflow 而言,行為已經變了。
Compatibility 可以先分成至少三層:
| 層級 | 問題 |
|---|---|
| Format compatibility | manifest / metadata 還讀得懂嗎? |
| Contract compatibility | 原本允許的 workflow 是否仍成立? |
| Behavioral compatibility | 升級後 Agent 會不會在新的條件停下、升級 verification 或拒絕 mutation? |
第三層最難。
它通常不能只靠 schema 判斷。
Shared Skill release 仍需要 verification,而 consumer adoption 也需要自己的 verification。
版本號只能指出「可能有差異」。
Evidence 才能回答「這個 consumer 能不能安全採用」。
比起複製兩個 SKILL.md,現在多了不少東西:
這些都有維護成本。
而且 consumer 很少時,成本尤其顯眼。
如果只有一個 Repository、一個人、Skill 也幾乎不改,做完整 rollout pipeline 很可能是過度工程。
我會在出現下面幾種訊號後,才認為版本治理開始值得:
□ 同一 Skill 被多個獨立 Repo 使用
□ consumer 不一定同時升級
□ 規則變更可能改變 stop / authority / verification 行為
□ 需要事後重建某次 Agent 當時遵守哪一版規則
□ consumer 可能產生值得 upstream 的差異
□ 「latest」已經不足以描述可重現狀態
如果這些都不存在,簡單 copy 也許才是比較合理的工程選擇。
版本號本身沒有解決 governance。Day 8 問的是「一段重複程序什麼時候值得抽成 Skill?」;走到 Day 9,門檻變成:
當 Skill 開始影響多個 Repository,就不能只治理它寫了什麼,還要治理誰正在使用哪一版。
此時 Context、Authority、Evidence 會再次碰在一起:
Context   → Agent 知道自己載入哪一版規則
Authority → release 與 adoption 不會因為「有最新版」就自動發生
Evidence  → 能追到 release、snapshot、version 與 verification
Shared Skill 變得可重用之後,它自己也成了需要被治理的工程資產。
版本、release、sync 都開始固定之後,另一個問題會浮出來。
這些步驟裡,有些完全可以 deterministic:
讀 manifest
比對版本
檢查 working tree
確認需要跑哪些 verification
但有些又需要 Agent 根據風險與任務內容判斷。
如果全部都塞進同一套重型流程,小改動也會付出完整成本。
下一個要拆的是:
哪些步驟應該固定成 Workflow,哪些判斷才值得留給 Agent?


 iThome鐵人賽
 看影片追技術